参考视频配音生成
可输入原始视频和新的音频轨道,生成重新配音后的视频,用于替换或制作人物说话内容。
BAIZE AI RESOURCE
InfiniteTalk
InfiniteTalk 是一套音频驱动的人物视频生成系统,可将新的音频配到参考视频或图片中,生成口型与语音同步、动作和表情随声音变化的长时长说话视频,适合视频配音与角色动画创作。
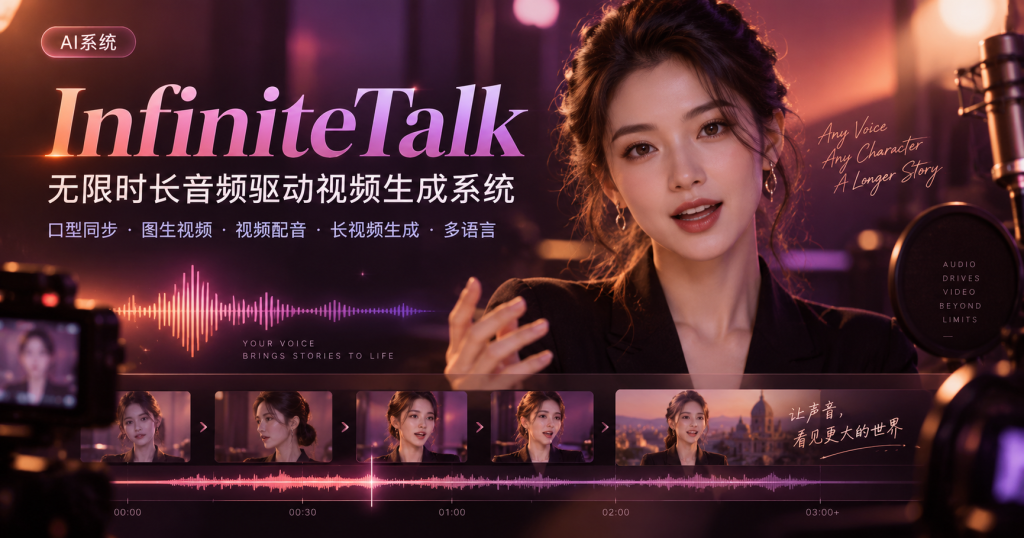
InfiniteTalk 面向人物视频配音和音频驱动角色动画场景。用户可提供一段参考视频与音频,为原视频生成新的配音版本;也可以上传单张人物图片和音频,生成说话视频。它不仅关注口型与声音的同步,还尝试让头部动作、身体姿态和面部表情随音频变化,并以保持人物身份一致性为目标。项目提供推理代码、模型权重入口和 Gradio 演示界面,适合需要制作长时长口播、角色配音或数字人物视频的创作者与开发者。
可输入原始视频和新的音频轨道,生成重新配音后的视频,用于替换或制作人物说话内容。
支持将单张参考图片与音频结合,生成由声音驱动的人物视频。
除口型同步外,还面向头部运动、身体姿态和面部表情与音频的对应关系进行生成。
项目将无限长度视频生成列为核心能力,面向持续时间较长的说话视频制作。
项目已提供 Gradio demo,便于通过界面体验生成流程。
使用场景创作者需要为已有的人物出镜视频更换旁白或台词。
上传参考视频和新的语音音频,生成与新语音同步的配音视频,并保持原人物身份特征。
使用场景内容创作者只有一张人物形象图和一段录音。
将人物图片与录音输入图片生成视频模式,获得由这段音频驱动的说话视频。
使用场景需要制作时长较长的角色讲解或连续口播内容。
以音频作为持续驱动信号生成长时长视频,减少将内容拆分为许多短片段的需求。