本地模型对话与生成
API 示例包含与模型对话和生成文本的调用方式,可用于在本机程序中发起模型请求并获取回答。
BAIZE AI RESOURCE
Ollama
Ollama 是用于在本机运行和调用大语言模型的软件,提供桌面应用、命令行与 API 示例,帮助个人用户和开发者完成模型下载、文本生成、对话调用及性能测试。
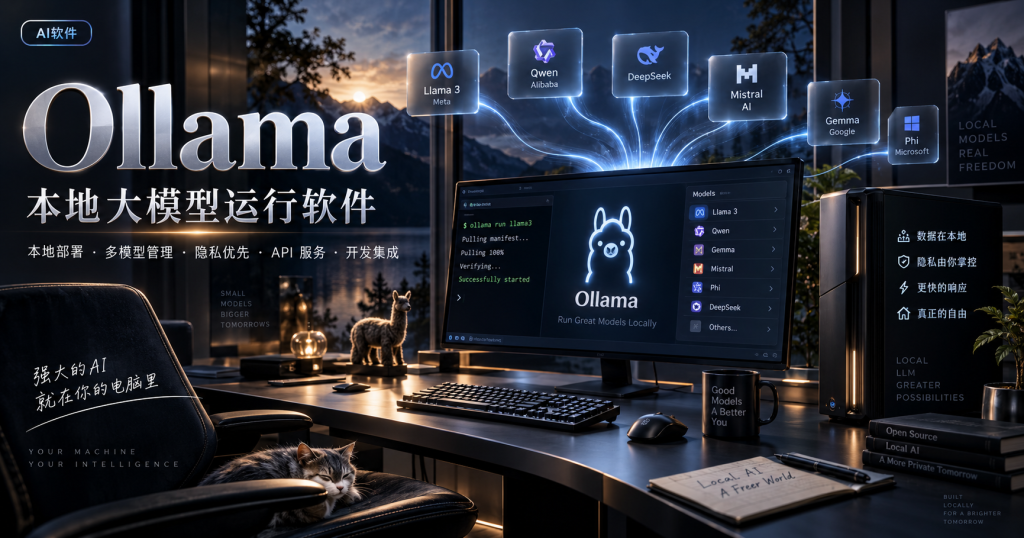
Ollama 面向希望在本地使用大语言模型的个人用户和开发者,提供 macOS、Windows 和 Linux 的发布包,并包含桌面应用与 API 调用能力。用户可下载并拉取所需模型,再通过对话或文本生成方式获得结果;开发者也可将其作为本地模型服务接入自己的应用。项目同时提供流式生成、多模态调用示例,以及模型基准测试工具,便于比较不同模型在生成速度、首个输出延迟和显存占用等方面的表现。
API 示例包含与模型对话和生成文本的调用方式,可用于在本机程序中发起模型请求并获取回答。
提供 generate-streaming 示例,可在模型生成过程中持续接收输出内容,适合聊天界面和实时反馈场景。
提供 pull-progress 示例,用于拉取模型并获取下载进度,方便为本地运行准备模型文件。
内置 ollama-bench 工具,可测试多个模型,并输出提示词处理、生成速度、首个 Token 延迟、加载时间及显存、内存相关信息。
发布资源包含 macOS 的 DMG、Windows 的 EXE,以及 Linux 的 x64 和 ARM64 安装包,便于在不同设备上部署。
使用场景个人效率
个人用户在电脑上安装 ollama 并拉取模型后,可通过对话方式向本地模型提问,用于日常问答和文本协助。
使用场景AI开发
开发者可参考流式生成示例调用本地模型服务,让应用在生成过程中逐步展示文本,而非等待完整答案返回。
使用场景开发者工具
开发者可使用 ollama-bench 对多个模型进行重复测试,比较生成速度、首个 Token 延迟及显存使用情况,为本机模型选择提供数据。