LLM 友好的 Markdown 输出
抓取后通过 markdown_generation_strategy 与 html2text 模块把页面转换为干净 Markdown,并可用内容过滤策略去除导航、广告等噪声,直接作为大模型上下文。
BAIZE AI RESOURCE
Crawl4ai
面向 AI 的开源网页爬虫与抓取框架,输出适配 LLM 的 Markdown 与结构化数据
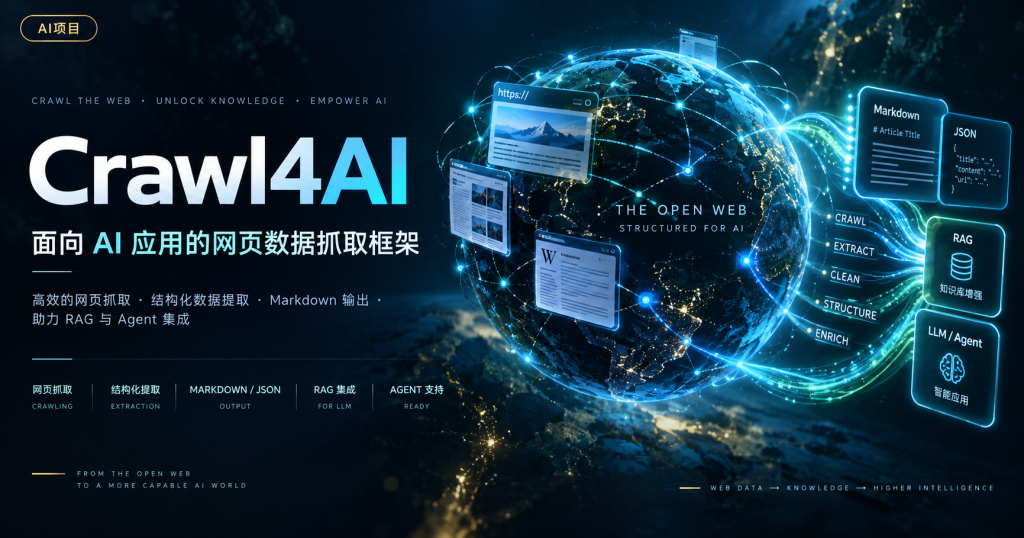
Crawl4AI 是一个专为 AI 场景设计的开源网页爬取框架。它用异步浏览器(Playwright)加载页面,把 HTML 清洗、去噪后转换为适合大模型消费的 Markdown,也可以通过 CSS/XPath 或 LLM 抽取策略输出结构化 JSON,从而解决“网页内容太脏、太长,无法直接喂给 LLM”的问题。
它的工作方式分为几层:核心是 AsyncWebCrawler 与 CrawlerRunConfig,负责并发抓取、会话保持、JS 执行、反爬检测与缓存;上层提供自适应爬取(统计策略与嵌入策略,判断内容是否已足够回答查询)、深度爬取(BFS/DFS/BFF 策略与过滤器、评分器)、内容过滤与分块策略;再上层是抽取策略(LLM 抽取、JSON CSS 抽取、表格抽取)以及 C4A-Script 可视化自动化脚本语言。项目同时提供 CLI(crwl)、Python SDK、Docker 镜像与 REST API 服务,并支持 MCP 协议接入 Claude Code 等客户端。
典型用户是需要为 RAG、Agent 或数据管道准备网页语料的开发者与数据团队,以及需要把网站变成 API 的工程团队。仓库内附带大量示例,包括 Amazon 商品抽取、LinkedIn 线索发现、自适应爬取对比、C4A-Script 交互教程和 website-to-api 示例。
抓取后通过 markdown_generation_strategy 与 html2text 模块把页面转换为干净 Markdown,并可用内容过滤策略去除导航、广告等噪声,直接作为大模型上下文。
adaptive_crawler 提供统计策略与嵌入策略,根据查询判断已抓内容是否足够,支持查询扩展与不相关内容检测,并可导出/导入知识库状态继续爬取。
deep_crawling 目录实现 BFS、DFS、BFF 等遍历策略,配合 filters 与 scorers 控制链接筛选和优先级,用于整站或多层页面采集。
提供 GO、WAIT、CLICK、TYPE、IF/THEN、PROC 等命令的脚本语言,可录制浏览器操作生成脚本,并可在 CrawlerRunConfig 中通过 c4a_script 参数执行。
deploy/docker 提供 REST API 服务、Playground 界面、JWT 认证、Webhook 异步任务与监控面板,并支持 MCP 协议供 Claude Code 等客户端调用。
使用场景电商商品数据采集
docs/examples/c4a_script/amazon_example 演示用 C4ACompiler.generate_script 从 HTML 片段生成搜索脚本与抽取 schema,在同一 session_id 下完成搜索、翻页与商品字段(标题、价格、评分、评论数、链接)抽取。
使用场景销售线索与客户画像分析
docs/apps/linkdin 提供三阶段流程:c4ai_discover.py 按关键词与 geoUrn 抓取公司与员工数据,c4ai_insights.py 用嵌入模型与 LLM 生成公司相似度图、组织架构和决策人清单,最后用 graph_view_template.html 可视化。
使用场景把任意网站变成数据接口
docs/examples/website-to-api 提供 FastAPI 服务,输入 URL 与自然语言查询即可返回结构化数据,支持 schema 缓存、多 LLM 提供商配置与请求历史记录。
使用场景为 RAG 构建高质量语料
docs/examples/adaptive_crawling 提供 basic_usage.py、embedding_strategy.py、embedding_vs_statistical.py 等示例,对比统计策略与嵌入策略在语义理解和无关内容检测上的差异。