Visionati
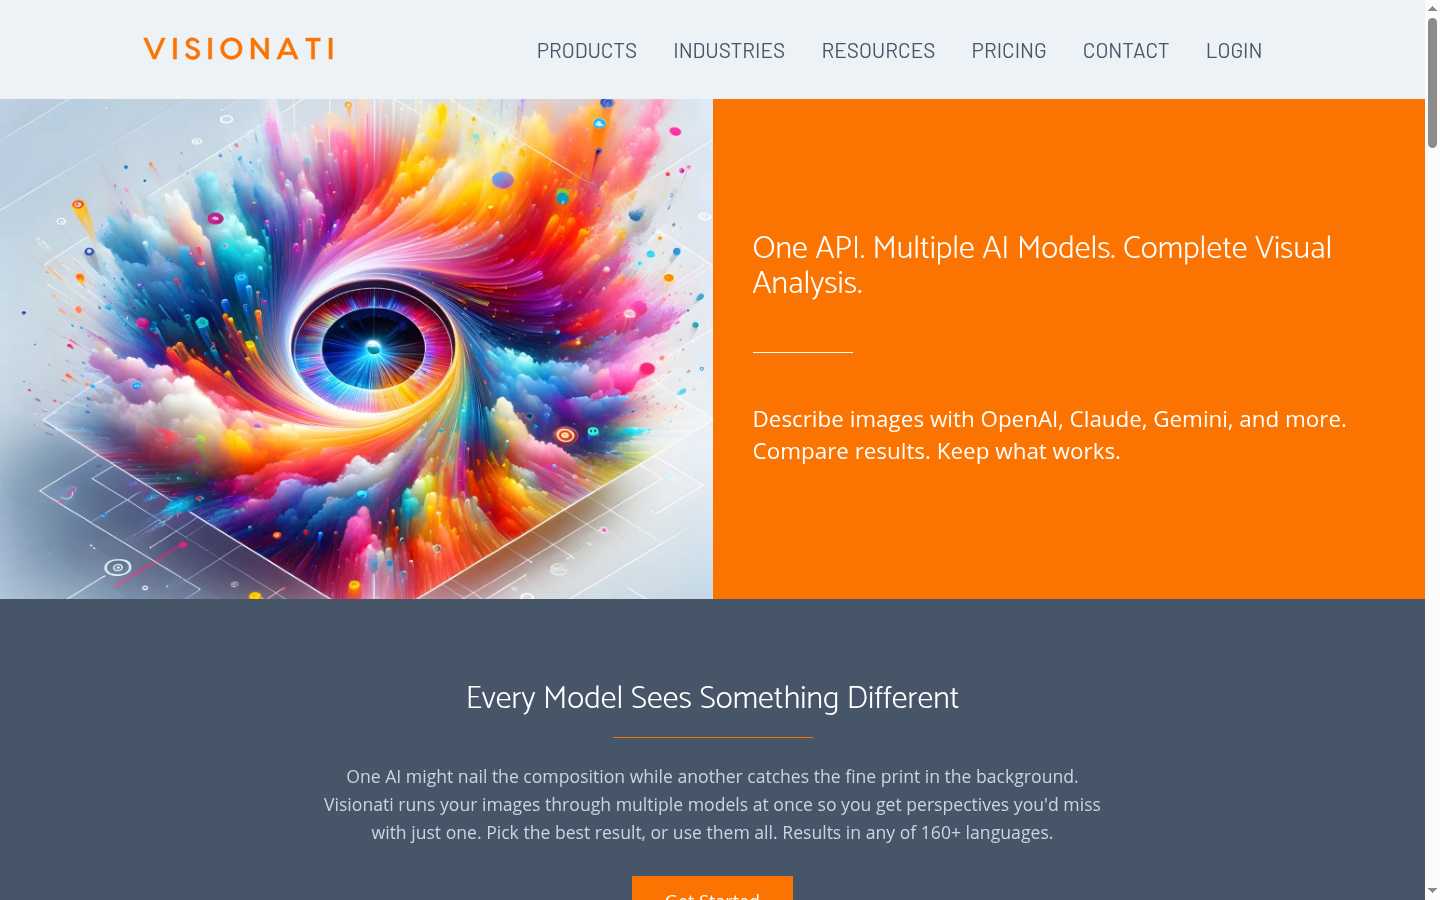
通过单一 API 和多种入口分析图像与视频内容的 AI 视觉分析工具。
工具介绍
Visionati 是一款多模型视觉分析平台,可通过单一 API 对图像进行描述、打标、文字识别、颜色提取及敏感内容检测,并支持比较不同模型的分析结果。它也提供浏览器扩展、Figma 插件及 Shopify、WordPress 等入口,适合开发者、电商团队、设计团队和需要整理视觉素材的用户。
核心功能
- 多模型结果对比:可在一次分析中使用多个 AI 与计算机视觉模型,并比较返回结果。
- 图像描述生成:可根据内置角色、提问或自定义提示词生成图片描述、标题、替代文本和商品文案。
- 自动图像打标:识别图片中的对象、场景和地标,帮助素材库进行搜索与分类。
- 敏感内容检测:支持识别图片和视频中的 NSFW 敏感内容,用于内容审核。
- OCR 与颜色提取:可从截图、文档和标识中提取文字,并输出主色调的十六进制颜色值。
- 多端使用方式:除 API 外,还提供浏览器扩展、Figma 插件、Shopify 应用和 WordPress 插件等入口。
使用方法
- 1进入 Visionati API,确定要完成的图像分析任务,例如生成描述、标签或敏感内容检测结果。
- 2提供图片 URL 或 Base64 图片数据,并选择适用的内置分析角色,或填写自定义提示词。
- 3调用已确认的图像分析能力;如需比较,可在同一请求中启用多个模型。
- 4查看返回的描述、标签、颜色、文字、面部信息或 NSFW 评分,并根据结果继续用于应用或内容工作流。
常见问题
Visionati 可以分析哪些视觉内容?
它可分析图像,并提供视频帧分析功能。已确认的输出包括图片描述、标题、标签、主色、文字识别结果、面部相关信息和 NSFW 评分。
Visionati 如何帮助电商团队处理商品图片?
Visionati 可为图片生成商品描述和替代文本,并提供 Shopify 应用,以及支持 WooCommerce 的 WordPress 插件,用于处理商品目录和媒体库内容。
Visionati 的多模型分析有什么作用?
它能通过一次 API 请求调用多个 AI 与计算机视觉模型,返回多个分析视角,用户可比较结果并选择更适合当前任务的输出。
能否不用编程分析图片?
可以。Visionati 提供无需编程的 Content Analyzer,可通过拍照或上传图片进行分析,单次最多可分析 5 张图片;也可用浏览器扩展右键分析网页图片。
Visionati 如何收费?
官网明确 Pay-Per-Use AI Credits
No Subscription。具体价格、额度与权益以官方当前方案为准。
中文支持的具体范围是什么?
官方输出语言列举 Chinese,内容描述可输出中文;公开工作台主要为英文。