Gemini
Google DeepMind 的前沿 AI 模型系列,结合智能与行动能力,助力完成复杂多步骤工作流。
工具介绍
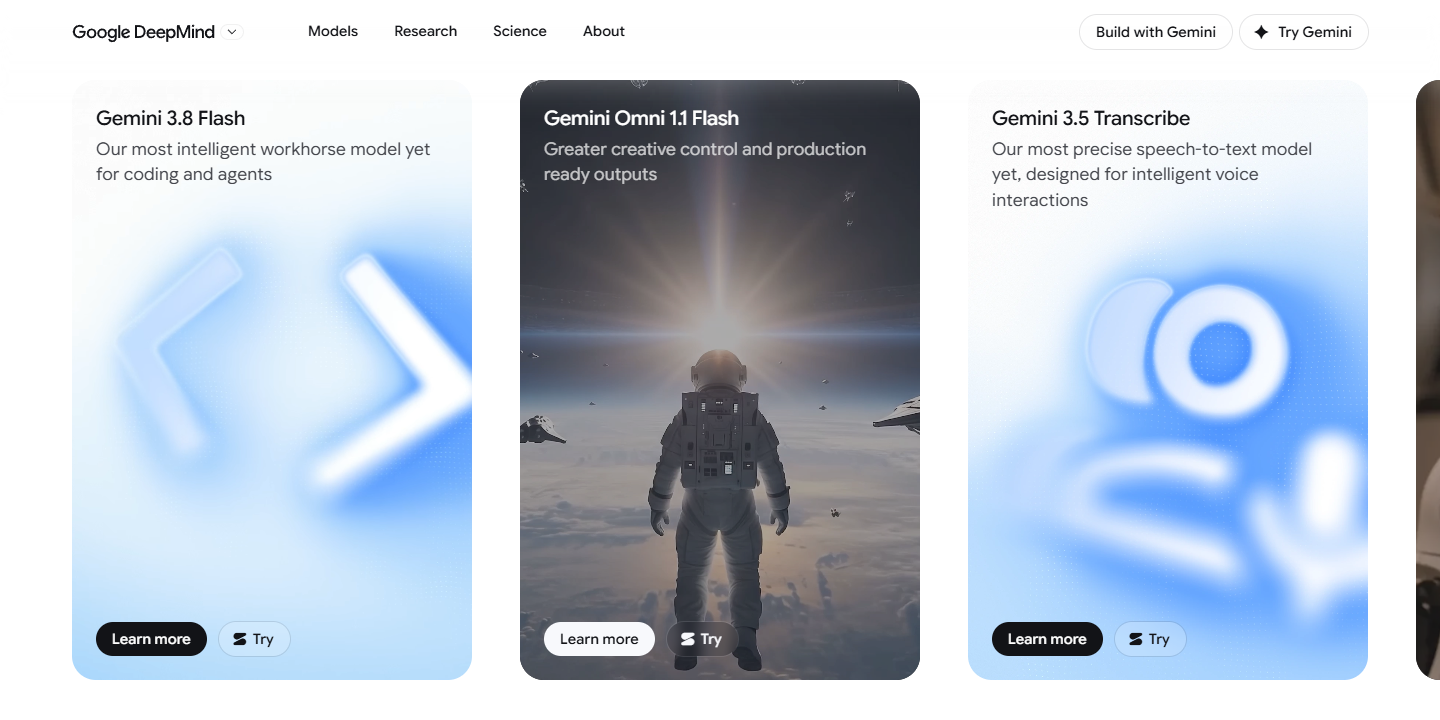
Gemini 是 Google DeepMind 开发的一系列前沿 AI 模型,旨在将智能与行动能力相结合,帮助用户执行复杂的多步骤工作流。该系列包含针对不同任务优化的模型变体,例如适合大规模智能体任务的 Gemini 3.8 Flash、适合高量任务的 Gemini 3.5 Flash-Lite、适合复杂任务与创意开发的 Gemini 3.1 Pro,以及面向科学、研究和工程挑战的 Gemini 3.1 Deep Think。此外,Gemini Omni 模型支持从任意输入(包括视频)生成内容,并可通过自然对话进行视频编辑。开发者可通过 Gemini API、Google AI Studio 等平台接入这些模型。
核心功能
- 智能体编码:具备高级推理能力,可处理复杂的开发任务。
- 高级多模态理解:能够将文本、图像、视频和音频转化为丰富的交互式界面。
- 长时程任务执行:支持在较长时间范围内执行复杂工作流。
- 多步骤问题解决:利用先进工具解决现实世界中的复杂问题。
- 视频生成与编辑:Gemini Omni 可从任意输入生成视频,并支持通过自然对话进行逐步编辑。
- 场景扩展与增强:支持将视频场景延长至 40 秒,并提供首尾帧插值、4K 升级和 360p 预览功能。
使用方法
- 1访问 Google DeepMind 官网,了解 Gemini 模型系列及其适用场景。
- 2根据任务需求选择合适的模型,例如复杂智能体任务选择 Gemini 3.8 Flash,创意视频生成选择 Gemini Omni。
- 3通过 Gemini 应用、Google AI Studio 或 Gemini API 等渠道开始使用所选模型。
- 4输入任务描述或素材,调用模型能力执行生成、分析或编辑等操作。
- 5检查返回的结果,并根据需要调整输入或继续后续步骤。
常见问题
Gemini 是什么?
Gemini 是 Google DeepMind 开发的一系列前沿 AI 模型,结合智能与行动能力,旨在帮助用户执行复杂的多步骤工作流。
Gemini 有哪些模型变体?
Gemini 系列包含多个模型,例如适合复杂智能体任务的 Gemini 3.8 Flash、适合高量任务的 Gemini 3.5 Flash-Lite、适合复杂任务与创意开发的 Gemini 3.1 Pro,以及面向科学、研究和工程挑战的 Gemini 3.1 Deep Think。此外还有专注于视频生成与编辑的 Gemini Omni。
如何开始使用 Gemini?
可以通过 Gemini 应用、Google AI Studio、Google Antigravity 或 Gemini API 等渠道访问 Gemini 模型。开发者可在 Google AI Studio 中快速试用,或通过 API 集成到应用中。
Gemini 支持哪些输入类型?
Gemini 模型支持多模态输入,包括文本、图像、视频和音频。例如 Gemini Omni 可以引用这些输入来生成连贯的输出。
Gemini Omni 可以做什么?
Gemini Omni 是一个可以从任意输入(如图像、文本、视频或音频)生成内容的模型,特别擅长视频生成和编辑。它支持通过自然对话进行逐步视频编辑,并应用物理、历史、科学等现实世界知识。